AIスクレイピング(AIがウェブ上のデータを自動収集すること)を拒否するための共通規格に、OpenAI、Google、Microsoft、Anthropicの主要AI企業が賛同しました。これにより、ウェブサイト運営者は個別の企業ごとに設定することなく、一度の手続きで複数のAIによるデータ収集を制限できるようになります。この仕組みは、インターネットの標準化団体であるIETF(Internet Engineering Task Force)を通じて提案されました。
どのような仕組みでAIスクレイピングを拒否するのか
具体的には、ウェブサイトの「robots.txt(ロボッツ・テキスト)」ファイル内に共通の「ポリシー・トークン」という信号を配置する仕組みです。robots.txtとは、検索エンジンのクローラー(自動巡回ソフト)に対して、サイトのどの部分を収集してよいかを伝える設定ファイルのことです。
賛同した企業は、この共通トークンを検知した場合、自社のAIクローラーによるアクセスを制限すると述べています。Meta(メタ)の広報責任者であるアンディ・ストーン氏も、業界全体で共通の信号を作成することは重要なステップであると支持を表明しました。
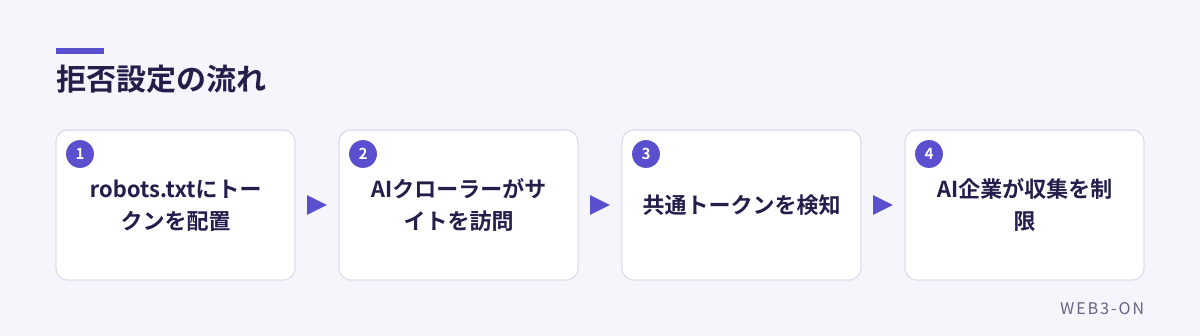
図1: 共通規格によるAI収集制限の仕組み
なぜ共通規格の導入が重要なのか
これまでウェブサイト運営者は、AIによる無断収集を防ぐために、AI企業ごとに個別の設定を行う必要がありました。また、Cloudflare(クラウドフレア)がデフォルトでAIクローラーをブロックする機能を提供したり、有料で収集を許可するRSL(Really Simple Licensing)規格が登場したりするなど、対策は分散していました。
Microsoft(マイクロソフト)は、AI学習への利用だけでなく、AIグラウンディング(AIが根拠となる情報源を参照し、嘘をつく「ハルシネーション」を減らすプロセス)への利用を個別に拒否できる詳細な制御を提供すると述べています。なお、これらの設定をしても、BingやGoogleなどの検索結果への表示には影響しないとしています。
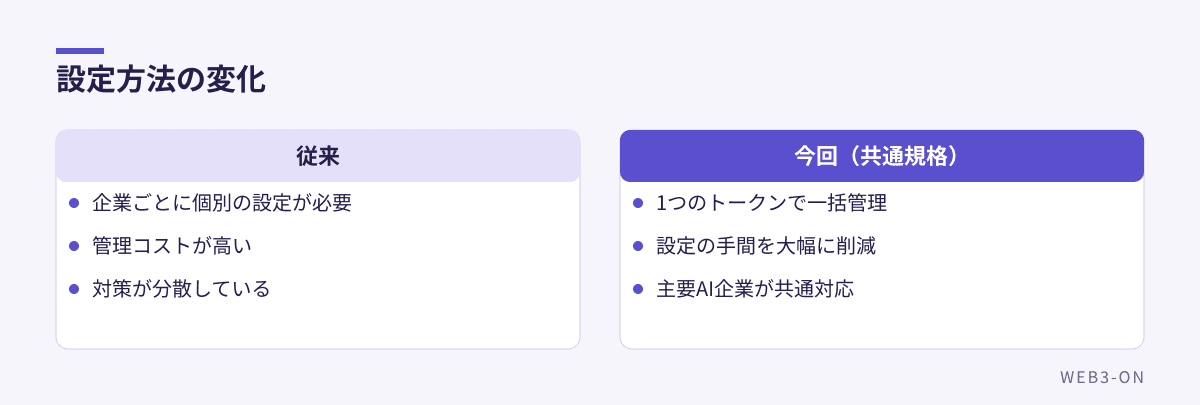
図2: 共通規格導入前後の比較
今後の導入スケジュールはどうなるのか
Anthropic(アンソロピック)はすでにこの信号を導入済みです。OpenAIは「今後数ヶ月以内」に実装するとしており、GoogleとMicrosoftは来年中のサポートを計画しています。
よくある質問
Q. AIスクレイピングを拒否すると、検索結果に表示されなくなる?
A. いいえ。MicrosoftやGoogleは、AI学習やAI機能への利用を拒否しても、検索結果への表示(インデックス)には影響しないとしています。
編集部の見方
コンテンツ制作者の権利保護に向けた現実的な一歩になると考えられます。個別の拒否設定は運用コストが高く形骸化しやすいため、業界標準の共通規格が整備されることで、AI企業とパブリッシャーの間でより透明性の高い合意形成が可能になるためです。
関連記事
- Thrive HoldingsがADTを買収、OpenAIと連携しAIセキュリティを強化
- AIエージェントを悪用したマルウェア感染の危険性、ダウンロードフォルダでの起動に注意
- OpenAIを提訴、GPT-4oが投薬中止を指示し女性が死亡したと遺族が主張
- AI情報の記事一覧
出典
- The biggest names in AI are backing a new way to opt out of scraping(The Verge、英語記事を要約・翻訳) — 2026-10-31
この記事は WEB3-ON 編集部が公開情報をもとに AI を用いて作成しました。内容の正確性には注意を払っていますが、詳細は出典をご確認ください。誤りや削除のご要望は お問い合わせ からお知らせください。
コメント