Google(グーグル)は、AI向けアクセラレータ(AI処理に特化した演算装置)である第8世代「TPU」のラインアップを拡充し、「TPU 8i Max」と「TPU 8tx」の2システムを追加すると発表しました。これにより、大規模なデータ処理と高度な機密保護という2つの異なるニーズに対応します。ハードウェアの構成を用途に合わせて最適化することで、処理能力の向上とセキュリティの強化を同時に実現しています。
GoogleはTPUのラインアップをどう拡充したのか
Googleは、第8世代TPUのラインアップを、大規模学習向けの「TPU 8t」とリアルタイム推論向けの「TPU 8i」に加え、新たに「TPU 8i Max」と「TPU 8tx」の4システムに拡大しました。今回の新システムは、既存のチップを活用しながら、パッケージやネットワーク、セキュリティ構成を用途に合わせて最適化したものです。
「TPU 8i Max」は、2つのTPU 8iチップを1つのパッケージに搭載することで、演算能力、SRAM(高速な一時記憶メモリ)容量、HBM(高帯域幅メモリ)のメモリ帯域幅をそれぞれ2倍に高めています。これにより、設置面積あたりの演算密度を向上させ、数百万トークン規模の膨大なコンテキスト(文脈)を扱う処理を可能にします。
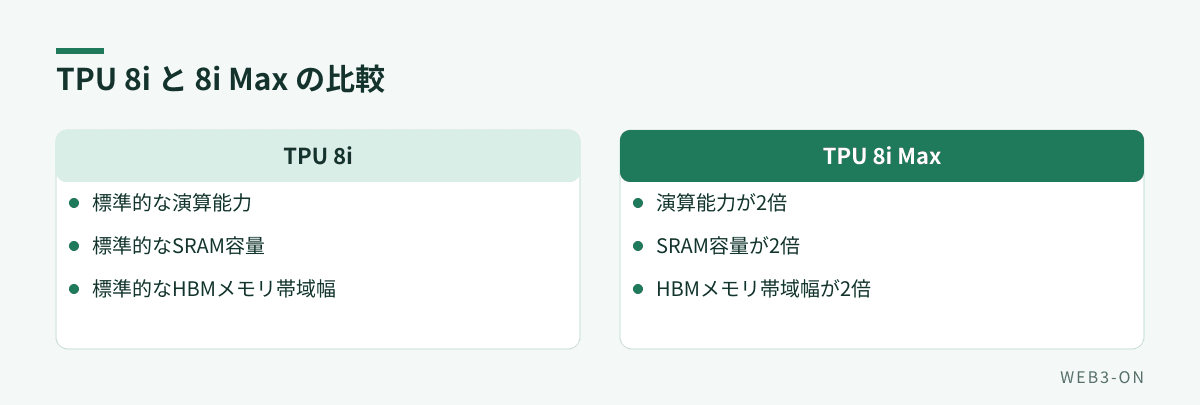
図1: TPU 8i Maxは主要スペックを2倍に高めている
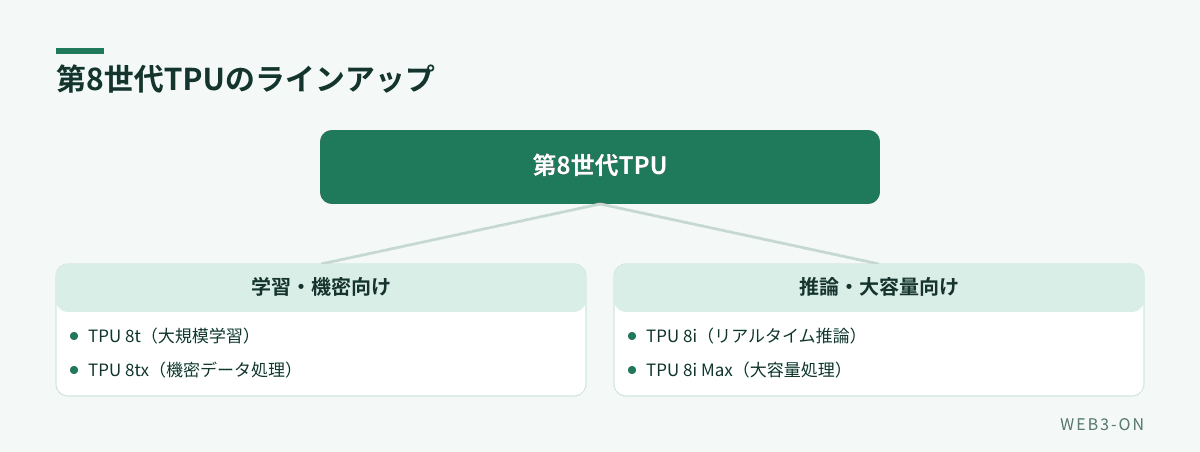
図2: 用途に合わせて4つのシステムに分かれている
機密データ処理とソフトウェアの効率化はどう変わるのか
機密性の高いデータを扱う企業や政府機関向けには「TPU 8tx」が提供されます。これはTPU 8tのシリコンにカスタムのAMD製CPUホストを組み合わせた構成で、処理中のデータやモデルの重みをハードウェアレベルで保護・分離します。また、低遅延の「Boardfly」ネットワークの採用により、TPU 8tと比較してレイテンシ(通信の遅延時間)を最大で半分に短縮しました。
あわせて、TPUクラスターのメモリやストレージを統合的に扱う「TPU Sync」のオープンソース化も発表されました。これにより、推論に用いるKVキャッシュ(過去の計算結果を保持するメモリ)の転送レイテンシと、最初のトークンを出力するまでの時間(TTFT)を90%以上削減できるとしています。
どのような用途での活用が見込まれるのか
TPU 8i Maxは、多数のAIエージェントが長時間の動画やコードベース全体を扱う際に発生する、メモリ帯域幅のボトルネックを解消することを想定しています。
一方のTPU 8txは、機密データを外部クラスターへ移すことなく、単一システム内でモデルの実行や追加学習、モデルの蒸留(大規模モデルの知識を小規模モデルに継承させること)、強化学習によるエージェント学習を行なえる環境を提供します。
よくある質問
Q. TPU 8i Maxで何ができるようになるのか
A. メモリ帯域幅が2倍に向上したため、数百万トークン規模の膨大なコンテキストを扱う処理や、長時間の動画、大規模なコードベースを扱うAIエージェントの運用が効率化されます。
編集部の見方
今回の拡充は、AIの利用シーンが「汎用的なチャット」から「専門的な業務ワークフロー」へと移行していることを反映しています。特に数百万トークンの処理能力向上は、企業の膨大な内部ドキュメントを一度に読み込ませるAIエージェントの実用化を加速させるでしょう。また、ハードウェアレベルでの機密保護を強化した点は、規制の厳しい政府や金融機関などのエンタープライズ市場への浸透を狙った戦略的な配置と言えます。
ユーザーや開発者は、今後クラウド経由で提供されるAIサービスの応答速度や、扱えるコンテキスト量の劇的な向上を実感することになるはずです。特に機密性の高いデータを扱う開発者は、ハードウェアレベルでの分離機能を持つインフラの選択肢を検討し始めるタイミングになるでしょう。
関連記事
- Gemini Omni 1.2 Flash登場、最大15秒の動画生成が可能に。料金は30%値下げ
- AIスクレイピング拒否の共通規格をOpenAIやGoogleらが導入へ
- Google Store 表参道が開業 海外初の旗艦店でPixelとAI戦略を前面に
- AI情報の記事一覧
出典
この記事は WEB3-ON 編集部が公開情報をもとに AI を用いて作成しました。内容の正確性には注意を払っていますが、詳細は出典をご確認ください。誤りや削除のご要望は お問い合わせ からお知らせください。
コメント