米Block(ブロック)は10月23日、テキストを一切使わず人間の会話音声のみで学習させた全二重音声モデル「Dessa(デッサ)」を研究プレビューとして発表しました。全二重とは、相手の話を聞きながら同時に話せる方式のことです。感情やニュアンスを直接処理できるため、人間と話しているような自然な体験が可能になります。なぜ今これが重要かといえば、従来の音声AIがテキスト変換時に失っていた「声の感情」という重要な情報を直接扱えるようになるためです。
Dessaは何が違うのか
Dessaは、音声を入力して音声を出力する「speech-to-speech(音声から音声へ)」モデルです。最大の特徴は、テキストや事前学習済みモデルを一切使わず、人間の会話音声だけでゼロから学習させた点にあります。これにより、どのタイミングで口を挟むかや、「うん」「なるほど」といった相づちの打ち方を身に付けています。
また、従来の音声AIの多くがユーザーの声を一度テキストに変換するのに対し、Dessaは音声を直接処理します。そのため、テキストでは表現できない皮肉や笑い、いら立ちのため息、悲しみに震える声などの感情やニュアンスを直接聞き取り、表現することが可能です。
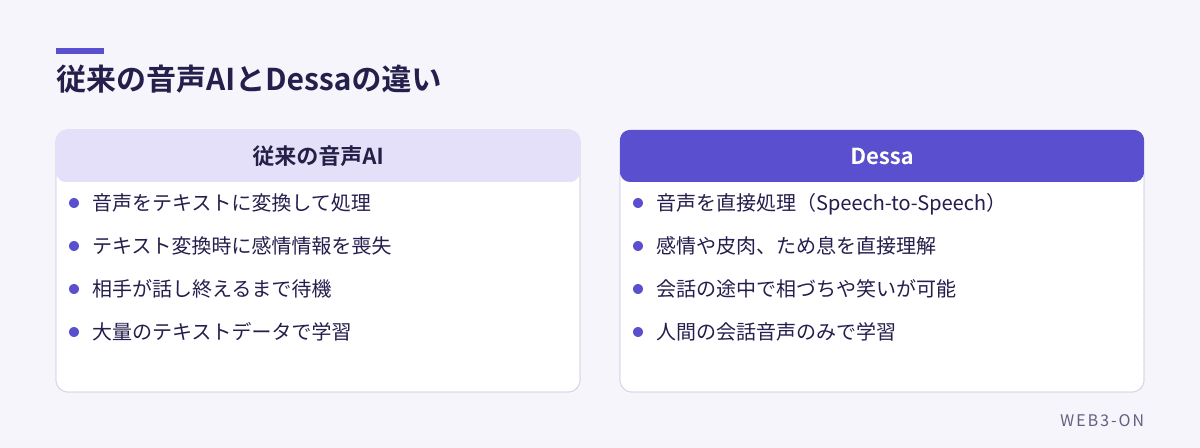
図1: 情報の処理経路と学習データの違い
学習方法にどのような革新があるのか
Dessaは、大規模言語モデル(LLM:大量のテキストデータを学習し、人間のように文章を生成するAI)と比べて数百分の1の単語量で言語を習得したとされています。学習に使用したのは、米NVIDIA(エヌビディア)の「GB200 NVL72」1台のみという極めて効率的な構成です。
推論速度はリアルタイムより高速で、応答待ちが発生しません。また、「M4 Max」以上を搭載した「MacBook Pro」でローカル実行(クラウドを介さず自身のデバイス上で処理すること)ができる点も特徴です。
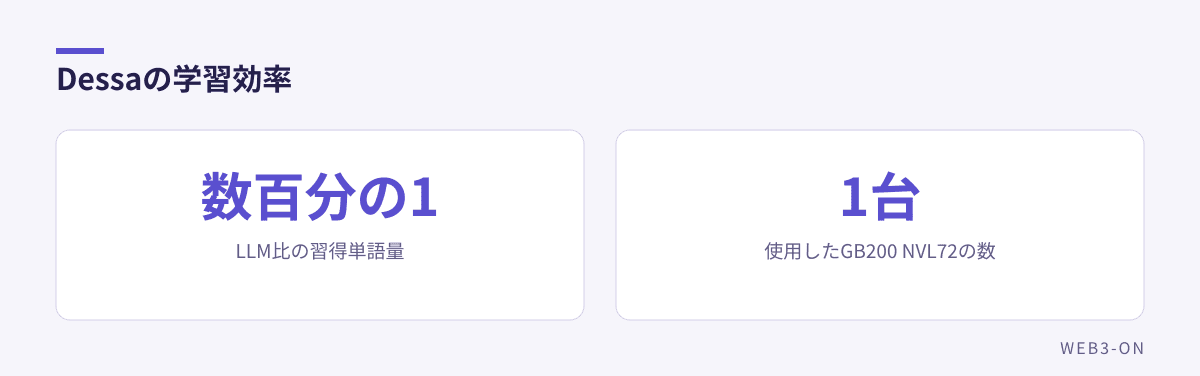
図2: LLMと比較して極めて少ないリソースで習得
今後の展開はどうなるのか
現在は研究プレビュー段階であり、一般提供の時期は明かされていません。まずは少数のAI安全性研究者に早期アクセスを提供し、想定外のリスクを洗い出す予定です。利用開始のためのリンクは近日中に公開されるとしています。
デモでは英語のみの会話が公開されており、相手の話の途中で笑ったり、声量を調整したりする振る舞いが披露されています。また、OpenAI(オープンエーアイ)の全二重音声モデル「GPT-Live-1」との会話デモも公開されていますが、DessaはGPT-Live-1とは異なり、全ての知識を音声のみから獲得したとしています。
よくある質問
Q. 自分のパソコンで動かせるのか
A. 「M4 Max」以上を搭載した「MacBook Pro」であれば、ローカルで実行可能としています。
Q. 日本語でも利用できるのか
A. 公開されているデモは英語のみであり、対応言語についての詳細は明らかにされていません。
編集部の見方
これまでの音声AIは「音声→テキスト→思考→テキスト→音声」という多段階の処理を経ており、その過程で声に含まれる感情などの非言語情報が削ぎ落とされてきました。Dessaが追求する「音声のみによる学習」は、AIが人間のコミュニケーションの本質である「間」や「感情」を直接理解することを目指した挑戦的なアプローチと言えます。特に、少ない計算リソース(GPU 1台)で効率的に学習させた点は、AI開発のコスト構造を変える可能性を秘めています。
今後は、カスタマーサポートやメンタルケアなど、言葉の内容以上に「どう伝えるか」が重要な領域での活用が期待されます。ユーザーとしては、今後公開される利用リンクをチェックし、実際に「感情の読み取り」がどの程度実用的かを見極めることが重要になるでしょう。
関連記事
- ニトリ、部屋写真から約2500商品をAI配置 家具ECの購入前体験を強化
- Google Store 表参道が開業 海外初の旗艦店でPixelとAI戦略を前面に
- BitGo CEOが100BTCを公開 Claudeへの挑戦が問うAI時代の暗号資産防衛
- AI情報の記事一覧
出典
この記事は WEB3-ON 編集部が公開情報をもとに AI を用いて作成しました。内容の正確性には注意を払っていますが、詳細は出典をご確認ください。誤りや削除のご要望は お問い合わせ からお知らせください。
コメント